価値の測り方
スキャン図面に文字検索を:171ページを338秒で認識、ページをめくる時間はどれだけ戻るか
図面一式のスキャンページでは Ctrl+F で何も見つからず、記号を一つ調べるにもめくるしかありません。スキャンページがすべて文字認識されると — 文字ページとスキャンを別々に数え、中断しても足りないページだけを読み直す — 積算技術者には毎月何時間が戻り、いちばん大きな一式は本当に最後まで終わるのか。
画像だけの図面一式は、積算技術者に毎月何時間を使わせているか
必要なのは月あたりの図面一式の数、一式のページ数、スキャン画像のページの割合、1時間あたりのコストだけ。検索回数、スキャンページを全部めくる時間、現在の時間はそこから導きます。すべて変更できます。
上の4つの数字から導いた値
前提 — 開いて一つずつ確認・変更
検索
図面目録
差し引く項目
これは見積もりであり、約束ではありません。正しく読み取れる割合がすべての項目の土台です。0 にすると A と B は 0 になり、差し引く項目だけが残ります。正直なモデルはそうでなければなりません。
積算技術者の手元に届く設計図書は、数百ページの PDF が普通で、そのかなりの部分がスキャン画像です。署名・押印した図面を 撮り直したもの、保管用に古い図面をスキャンしたもの。そうしたページでは Ctrl+F で一文字も見つかりません。基礎のコンクリート 強度がどこに書いてあるか、柱 C1 の断面はいくつか、かぶり厚さの注記はどの図面か — それを知るには一枚ずつめくります。
この記事の問いは、スキャンページがすべて文字として認識され、普通のページと同じように検索できたら、技術者には毎月何時間が 戻ってくるのかです。そしてその前に来る問いがあります。その文字認識は、一式を最後まで処理できるのか。
1. 何が変わるのか
図面一式をアップロードすると、機械は二種類のページを分けて別々に数えます。文字を持つページ(ファイルからそのまま読む)と、 スキャン画像のページ(認識が必要)です。状態表示はファイル全体を語ります。例えば「312ページ:文字あり267ページ、スキャン45 ページ — 45ページを58秒で文字認識」。以前は「45ページを認識」とだけ表示され、読む人は 45 ページ目で止まったと受け取っていました。
そのうえで:
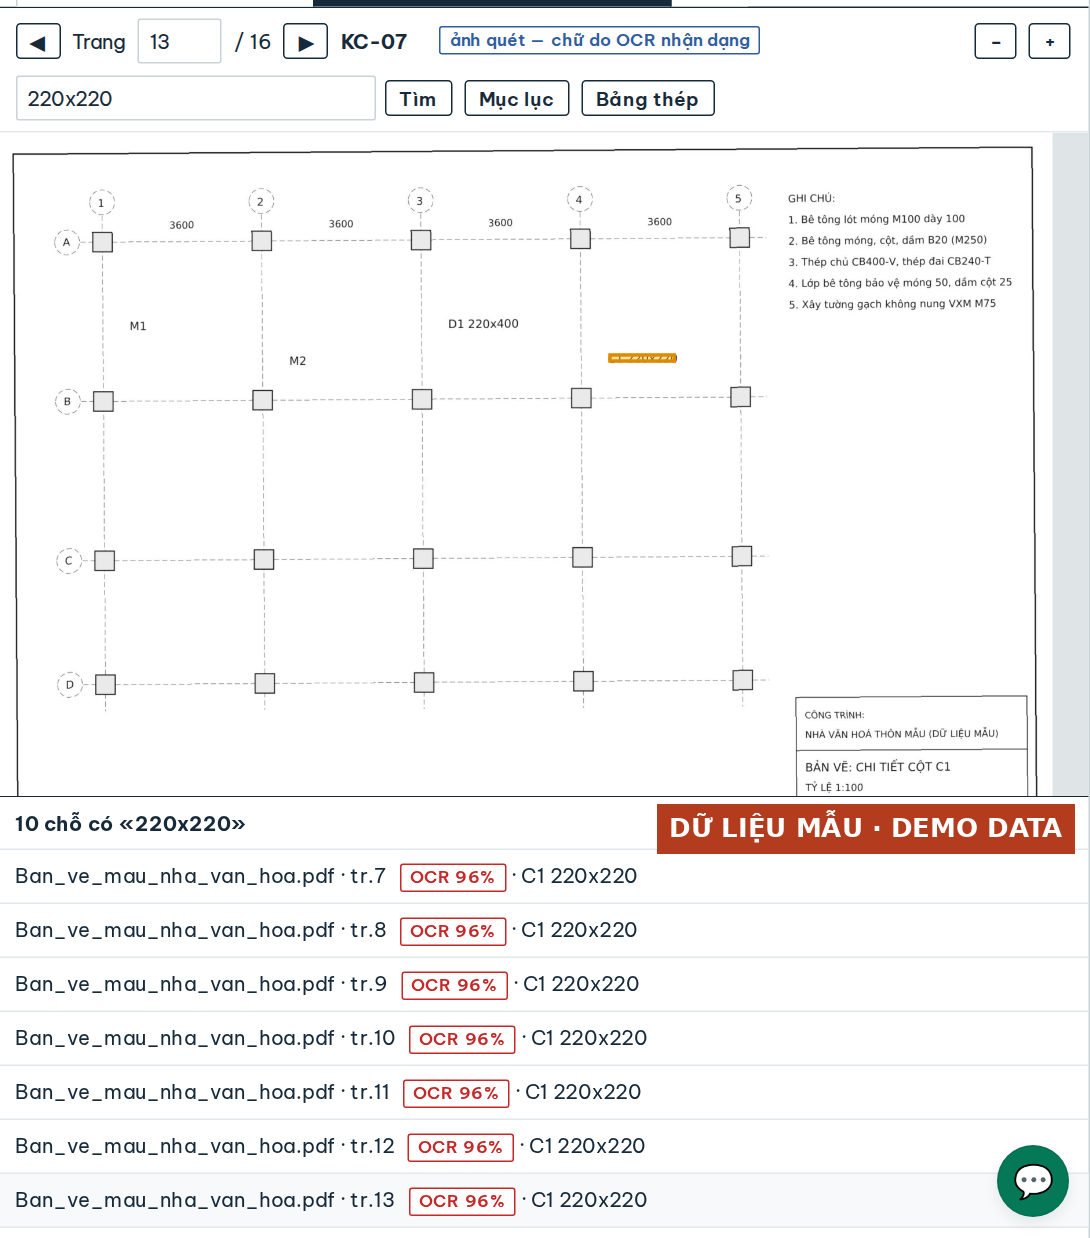
- スキャンページはすべて文字認識されます。ベトナム語と英語、サーバーの CPU で処理します。スキャンページからの検索結果には 「OCR」と信頼度が付き、信じる前に図面を見直すべきだと分かります。
- スキャンの表題欄から読んだ図番と図名は、文字ページと同じく図面目録に入ります。
- 途中で中断しても最初からやり直しません。 結果は 10 ページごとに保存されるので、再実行では足りないページだけを 読みます。試験:171ページの一式で 30 ページ目に止め、再実行では残りの 141 ページだけを読みました。
- 大きな一式は 8 MB ずつ分けてアップロード。 サーバーの前にある配信ネットワークは 100 MB を超える要求を拒否し、ブラウザは 何も表示しません。117 MB の一式が 5 KB/秒で 18 分這っていたことがあります。今はネットワーク障害に当たった部分だけを送り直し、 送り直しても重複ファイルはできません。
2. 先に来る問い:最後まで終わるか
スキャンした A3 一枚の文字認識は、単独で 1〜53 秒かかります。171ページの一式を開発機で 6 プロセス並列に処理すると 338 秒、1ページ約 2 秒でした。
実際のサーバー — 4 コアで、他のシステムと共用 — では、同じ一式が最初は終わりませんでした。300 秒の上限で止まったのです。 測った原因:6 プロセスが同時に動き、各プロセスがコアごとにスレッドを開くため、24 スレッドが 4 コアを奪い合っていました。 プロセスごとに 1 スレッドに制限し、並列数をコア数マイナス 1 にすると、同じマシンで同じ 171 ページが 352 秒で終わりました。
これは下のどの数字よりも重要です。認識が終わらない一式は「検索が遅い」のではなく、何も見つからないのです。その一式で何かを 調べる必要のある作業はすべて止まるか、手でめくる方法に戻ります。下の計算機は、処理が終わった一式の時間だけを数えます。完全に 止まる作業は入っていないので、合計は下限です。
3. 一つ目の源泉:スキャンページでの検索
文字を持つページにある語は、今でも検索欄で見つかります。スキャンページにあればめくるしかなく、平均すると半分のところで出会い ます。スキャンに文字が付くと、正しく読み取れた分は検索の段階に移り、読み違えた分は以前どおりめくることになります。上のグラフは まさにこの計算で、二本の曲線の間の塗りつぶしが検索一回あたりの短縮分です。
測り方。 一週間、図面一式で何かを探すたびに印を付け、時間を計ります。文字ページで見つかった回とスキャンで見つかった回を 分けて数えます。正しく読み取れる割合は自分の一式で測ります。位置の分かっている 20 語を一つずつ検索し、正しいページに当たった 数を数えます。
信頼度: まずまず。検索回数とめくる秒数は、一式に慣れた人と初めて開く人で大きく違います。正しく読み取れる割合はスキャンの 質で決まります。傾き、ぼやけ、文字に赤い印が重なっていれば、はっきり下がります。
4. 二つ目の源泉:図面目録
測り方。 次に図面目録を作るとき、スキャン 20 枚で時間を計ります。そしてツール上で、直さずに正しい図番が出た枚数を数えます。
信頼度: まずまず。表題欄は設計事務所ごとに違い、見慣れない形式では正しく読める割合が下がります。
5. 差し引く項目:待ちと確認
171ページの一式の認識はサーバーで約 6 分、裏で動き、AI モデルの利用料はかかりません — この部分は CPU で動く文字認識 ソフトを使います。それでも利用者の時間は使います。待つ、エラー表示のページを見直す、再実行を押す。一式 10 分として: 4 × 10 ÷ 60 ≈ 月 0.7 時間。
6. 合計
| 源泉 | 時間/月 | 金額/月(時給 80,000 ドン) |
|---|---|---|
| スキャンページでの検索 | 8.9 | 71 万ドン |
| 図面目録 | 2.2 | 18 万ドン |
| 待ちと確認 | −0.7 | −5 万ドン |
| 戻ってくる時間 | 10.4 | 83 万ドン |
月 4 式を読む技術者一人で、月約 10 時間、例の給与水準で年 1,000 万ドン近くになります。現在、それらの一式での検索と 目録作りには約 16.5 時間かかっています。
一度だけ数える。 この 10 時間はお金か、より多くの図面を引き受ける余力のどちらかで、両方ではありません。そして 2 節で 述べたとおり、この数字には今日誰も何も探せない一式は入っていません。
7. この ROI が立っている前提
正しく読み取れる語の割合。 二つの源泉の両方の下にある前提です。計算機で 0 にすると、検索も目録も 0 になり、差し引く項目 だけが残ります。画面のサンプル一式では、はっきりした印字が信頼度 96% で読めました。実際のスキャンでは、手書き、印の下の文字、 Ø のような鉄筋表記はよく読み違えられます。だからスキャンページからの結果には必ず「OCR」と信頼度が付きます。図面を見直せという 合図であって、飾りではありません。
見つからないことは、無いことではありません。 機械が読み違えた語は検索結果に出ません。見落とすとお金がかかるもの — 材料の 注記、平面図と食い違う詳細 — については、技術者が一式を知っている必要があります。ツールはページまでの道のりを縮めるだけで、 読むことの代わりにはなりません。
一式あたりの検索回数は最も言い過ぎやすい数字です。60 を信じる前に一週間測ってください。
8. 自社で測る
- 基準を取る。 作業中の一式を選び、全ページに対するスキャンページを数えます。一週間、検索回数と一回の分数を記録し、 スキャン 20 枚で目録作りの時間を計ります。
- 同じ一式をツールで処理する。 認識時間、失敗ページ、位置の分かっている 20 語での正しく読める割合を記録します。
- 同じ種類で比べる。 鉄筋表記の多い構造図と文字の多い意匠図は違います。構造図は構造図と比べます。
9. 覚えておくこと
検索できないページは、必要になるたびに目で読み直すページです。 文字認識で図面を読む速さが上がるわけではありません。正しい ページにたどり着く手間がなくなるのです。そして節約を数える前に、もっと素朴な問いを立ててください。いちばん大きな一式は、本当に 最後まで処理できますか。
検索できない図面一式は遅いのではない — 止まるのだ。
認識時間(開発機で 171 ページ 338 秒、4 コアのサーバーで 352 秒)、修正前の 300 秒上限での停止、文字ページ 267・スキャン 45 の 312 ページの一式、5 KB/秒でアップロードされていた 117 MB の一式は、Xây dựng G20 で実際の設計図書を使って測ったもので、 匿名化しています。画面はサンプルプロジェクトのものです。月あたりの一式数、スキャンの割合、検索回数、めくる秒数、正しく読める 割合、給与は例示の数字です。ご自身の数字に置き換えてください。
次に読む
-
請求書を二重に作らない:作る前に会計帳簿に問い合わせる、209件中199件はすでにあった
請求書の作成を会計ソフトからERPへ移すとき、両方で請求書を作る期間が生まれます。ERPが作る前に会計帳簿に直接問い合わせれば、切り替え一回で何件の重複を避けられるのか。後始末せずに済む重複一件はいくらに当たるのか。
-
積算書を一つのリンクで共有する:Excel をメールで回す往復に何時間かかり、「どれが最新版?」はなぜ起きるか
積算書一式は Excel ファイルのメールで 2〜4 人の間を回り、いつも誰かが「どれが最新版?」と尋ねます。一式すべて — 図面、数量表、一つひとつの数字の出どころ — が一つの共有プロジェクトの後ろにあり、メールで共同作業に招くか、アカウント不要の閲覧専用リンクを送れるなら、確認の往復は毎月何時間を取り戻せるのか。
-
元の発注書単価で請求する:納品書は21,000、チェーンのPOは30,000
スーパーチェーンが支払うのは自社のPOに書いた単価で、仕入先の納品書の単価ではありません。機械がPO単価を読み、差が妥当ならその単価で請求し、次回のために価格表を直すと、毎月いくらになるのか。どの行は人が判断するのか。