怎么衡量价值
让扫描图纸也能搜索:171 页在 338 秒内识别,翻页的时间能拿回多少
在一套图纸里,扫描页用 Ctrl+F 什么也找不到,查一个符号只能翻页。当每一页扫描图都被识别出文字 — 文字页和扫描页分开计数,中断后重跑只读缺少的页 — 一名造价工程师每月能拿回多少小时,最大的那套图纸又能不能跑完?
一套全是扫描图片的图纸,每月要花掉造价工程师多少小时?
只需要每月的图纸套数、每套页数、扫描页所占比例和每小时成本。查找次数、翻完所有扫描页的时间和目前的小时数都由此推出。全部可以修改。
由上面四个数字推出
假设 — 展开查看并逐项修改
查找
图纸目录
需扣除的项
这是估算,不是承诺。识别正确的比例是所有项目的基础:把它设为 0,A 和 B 都归零,只剩扣除项。诚实的模型必须做得到这一点。
送到造价工程师手里的一套设计图纸,通常是几百页的 PDF,其中相当一部分是扫描图片:签字盖章后重新拍照的图纸,或为了 存档而扫描的旧图。在这些页上,Ctrl+F 一个字也找不到。想知道基础混凝土标号写在哪里、柱 C1 的截面是多少、保护层的说明在哪 一张图上,只能一页一页地翻。
本文要问的是:如果每一页扫描图都能识别出文字、像普通页面一样搜索,一名工程师每月能拿回多少小时? 还有一个更靠前的 问题:这种识别能不能把整套图纸跑完。
1. 改变了什么
上传一套图纸时,机器把两类页面分开并分别计数:自带文字的页(直接从文件读取)和扫描图片页(需要识别)。状态行说的是 整个文件,例如「312 页:267 页自带文字,45 页是扫描 — 已在 58 秒内识别 45 页」。以前只显示「已识别 45 页」,读的人以为 机器停在了第 45 页。
在此之后:
- 每一页扫描图都会被识别出文字,越南语和英语,用服务器的 CPU 运行。来自扫描页的每个搜索结果都标有「OCR」和置信度, 让使用者知道在相信之前要回看图纸。
- 从扫描页图签读出的图号和图名,像文字页一样进入图纸目录。
- 中途被打断不必从头再来。 每 10 页保存一次结果,所以重跑只读缺少的页。实测:171 页的一套在第 30 页处中断, 重跑只读了剩下的 141 页。
- 大套图纸按 8 MB 分段上传。 服务器前面的分发网络拒绝任何超过 100 MB 的请求,而浏览器什么也不提示:一套 117 MB 的 图纸曾以 5 KB/秒爬了 18 分钟。现在哪一段遇到网络错误就单独重发那一段,重发也不会产生重复文件。
2. 先要回答的问题:能不能跑完
单独识别一张扫描的 A3 需要 1 到 53 秒。一套 171 页,在开发机上用 6 个进程并行测得:338 秒,约每页 2 秒。
在真实服务器上 — 4 核,与其他系统共用 — 同一套图纸起初没有跑完:停在了 300 秒的上限。测得的原因:6 个进程同时运行, 每个进程又按核数各开一个线程,变成 24 个线程争抢 4 个核。把每个进程限制为一个线程、并行数设为核数减一之后,同一台机器上的 同样 171 页在 352 秒内完成。
这一点比下面任何数字都重要。一套识别跑不完的图纸不是「搜索更慢」— 而是什么也找不到,所有需要在这套图里查东西的工作 要么停下,要么回到手工翻页。下面的计算器只计算已经跑完的图纸上的小时数;彻底停下的工作不在其中,所以总数是下限。
3. 第一项来源:在扫描页上查找
在自带文字的页上的词,今天就能用搜索框找到。在扫描页上就只能翻,平均翻到一半时遇到它。扫描页有了文字之后,识别正确的那 部分转到搜索这一步;识别错误的部分仍然要像以前一样翻。上面的图表正是这个算式:两条曲线之间的阴影就是每次查找节省的分钟。
怎么测。 一周内,每次要在图纸里找东西就记一笔并计时。把在文字页上找到的和在扫描页上找到的分开数。正确识别比例用你自己 的图纸来测:取 20 个已知位置的词,逐个搜索,数一数有多少落在正确的页上。
可信程度: 中等。查找次数和每页秒数,熟悉这套图的人和第一次打开的人相差很大。正确识别比例取决于扫描质量 — 歪斜、模糊、 或者红章压在字上,都会明显降低。
4. 第二项来源:图纸目录
怎么测。 下次编图纸目录时,在 20 张扫描图上计时。然后在工具里数一数有多少张图号正确、不需要修改。
可信程度: 中等。每家设计单位的图签格式不同;格式陌生时,正确识别的比例较低。
5. 需扣除的项:等待与核对
一套 171 页的识别在服务器上约 6 分钟,在后台运行,没有 AI 模型费用 — 这部分用的是在 CPU 上运行的文字识别软件。使用者仍然 要花时间:等待、复查报错的页、点击重跑。按每套 10 分钟计:4 × 10 ÷ 60 ≈ 每月 0.7 小时。
6. 合计
| 来源 | 小时/月 | 金额/月(每小时 80,000 越南盾) |
|---|---|---|
| 在扫描页上查找 | 8.9 | 71 万越南盾 |
| 图纸目录 | 2.2 | 18 万越南盾 |
| 等待与核对 | −0.7 | −5 万越南盾 |
| 拿回的时间 | 10.4 | 83 万越南盾 |
一名每月读 4 套图纸的工程师,每月约 10 小时,按例子里的工资一年接近 1,000 万越南盾。今天,在这些图纸上查找和编目录要花 约 16.5 小时。
只算一次。 这 10 小时要么是钱,要么是多接图纸的能力,不能两样都算。而且正如第 2 节所说,这个数字没有算上那些 今天谁也查不到任何东西的图纸。
7. 这个 ROI 建立在什么假设上
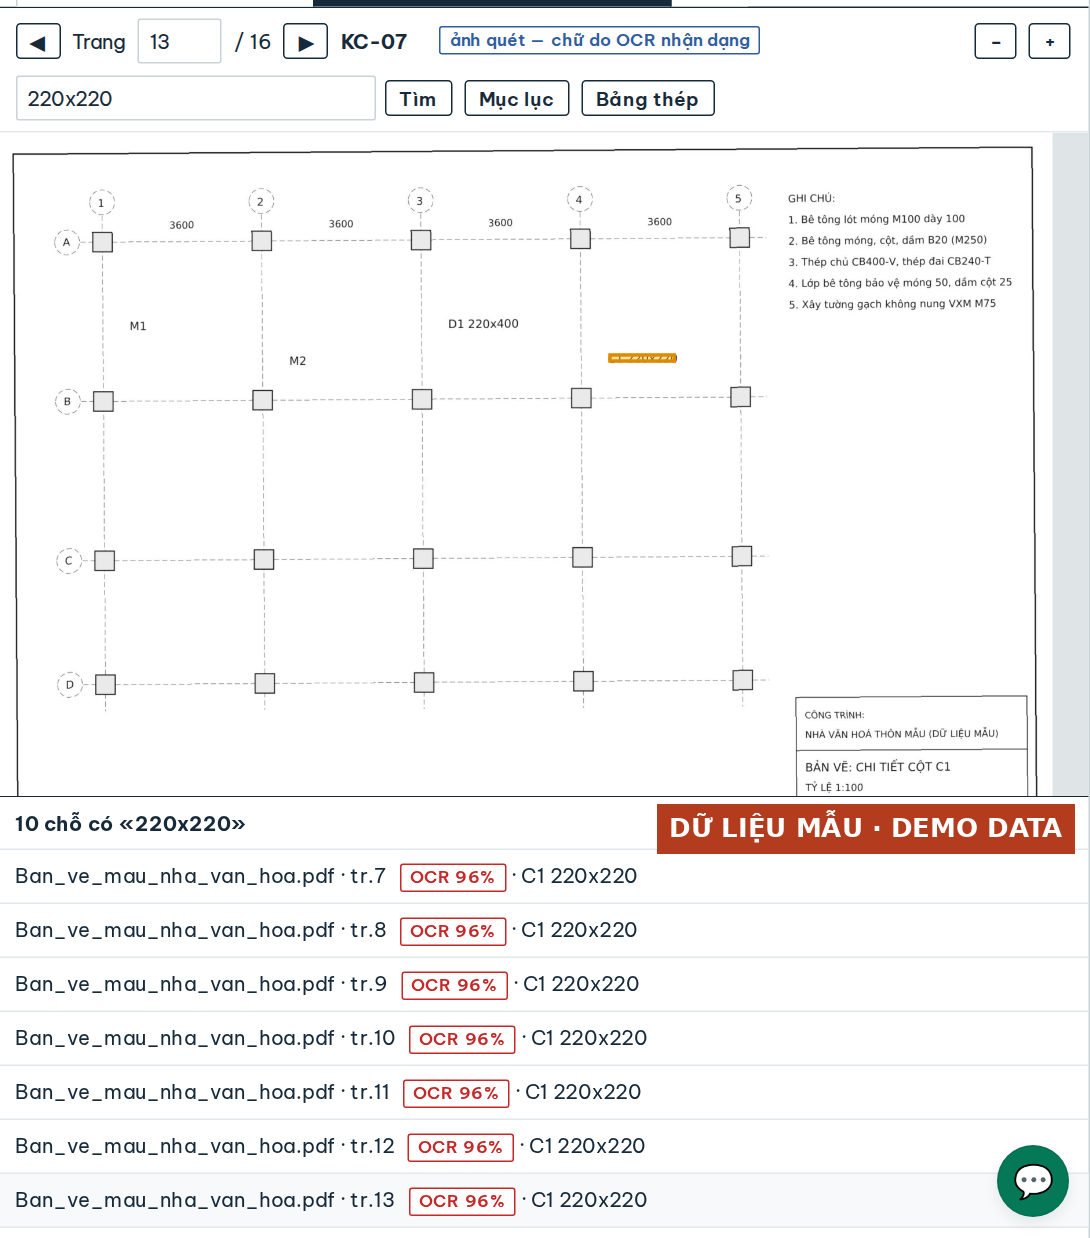
要找的词被正确识别的比例。 它在两项来源之下。在计算器里把它设为 0:查找和目录都归零,只剩扣除项。在截图的示例图纸上, 清晰的印刷字以 96% 的置信度读出;在真实扫描上,手写字、被章压住的字、或者 Ø 这类钢筋符号常常被读错。所以来自扫描页的每个 结果都标有「OCR」和置信度 — 那是提醒你回看图纸,不是装饰。
找不到不等于没有。 机器读错的词不会出现在结果里。对于漏掉就要花钱的东西 — 一条材料说明、一个与平面图矛盾的详图 — 工程师仍然要熟悉这套图;工具缩短的是到达那一页的路,不能代替阅读。
每套查找次数是最容易说多的数字。在相信 60 之前,先测一周。
8. 在你自己的公司里测
- 取基线。 选一套正在做的图纸。数扫描页占全部页数的比例;一周内记录查找次数和每次分钟数;在 20 张扫描图上给编目录计时。
- 在工具上跑同一套。 记录识别时间、失败页数,以及 20 个已知位置的词的正确识别比例。
- 同类相比。 钢筋符号多的结构图和文字多的建筑图不同;结构图和结构图比。
9. 值得记住的
搜索不到的一页,就是每次用到都要用眼睛重读的一页。 文字识别不会让人读图更快 — 它让走到正确那一页不再费力。在计算节省 之前,先问一个更朴素的问题:你最大的那套图纸,真的能跑完吗?
一套搜索不了的图纸不是更慢 — 而是停下了。
识别时间(开发机上 171 页 338 秒,4 核服务器上 352 秒)、修复前停在 300 秒上限、267 页文字页加 45 页扫描页的 312 页图纸、 以 5 KB/秒上传的 117 MB 图纸,均在 Xây dựng G20 上用真实设计图纸测得,已匿名处理。截图来自一个示例项目。每月图纸套数、扫描 比例、查找次数、每页秒数、正确识别比例和工资都是示例数字。请换成你自己的。
继续阅读
-
用一个链接共享预算:邮件来回传 Excel 要花多少小时,「哪个是最新版?」从何而来
一套预算通过邮件里的 Excel 文件在 2–4 个人之间流转,总有人问「哪个是最新版?」。当整套资料 — 图纸、工程量表、每个数字的来源 — 放在一个共享项目后面,可以按邮箱邀请一起做,或发一个无需账户的只读链接,审阅往返每月能拿回多少小时?
-
不重复开票:开票前先查会计账簿,209张中有199张已经存在
开票工作从会计软件迁入ERP时,会有一段两边都在开票的时间。如果ERP在开票前直接查询会计账簿,一次切换能避免多少张重复发票——每张不必清理的重复发票又值多少?
-
按采购订单原价开票:送货单写21,000,连锁超市的PO写30,000
连锁超市按自己PO上的单价付款,而不是按供应商送货单上的单价。当机器读取PO单价、在差额合理时按它开票,并为下一次自动修正价目表,每月值多少钱——哪些行仍要由人决定?