가치를 재는 법
스캔 도면에 글자 검색을: 171쪽을 338초에 인식, 쪽 넘기던 시간은 얼마나 돌아오나
도면 세트의 스캔 쪽에서는 Ctrl+F로 아무것도 찾지 못해 기호 하나를 찾으려 해도 넘겨야 합니다. 스캔 쪽이 모두 글자로 인식되면 — 글자 쪽과 스캔 쪽을 따로 세고, 끊겨도 빠진 쪽만 다시 읽으면 — 적산 기술자는 매달 몇 시간을 돌려받고, 가장 큰 세트는 정말 끝까지 도는가.
이미지뿐인 도면 한 세트는 적산 기술자에게 매달 몇 시간을 쓰게 하는가?
필요한 것은 한 달 도면 세트 수, 세트당 쪽수, 스캔 이미지 쪽의 비율, 시간당 비용뿐입니다. 검색 횟수, 스캔 쪽을 모두 넘기는 시간, 지금의 시간은 거기서 나옵니다. 모두 고칠 수 있습니다.
위 네 숫자에서 나온 값
가정 — 펼쳐서 하나씩 보고 고치기
검색
도면 목록
빼야 할 항목
이것은 추정이지 약속이 아닙니다. 바르게 읽는 비율이 모든 항목의 토대입니다. 0으로 두면 A와 B가 0이 되고 빼는 항목만 남습니다. 정직한 모델은 그렇게 될 수 있어야 합니다.
적산 기술자에게 오는 설계 도서는 보통 수백 쪽짜리 PDF이고, 그중 적지 않은 부분이 스캔 이미지입니다. 서명·날인한 도면을 다시 찍은 것, 보관용으로 옛 도면을 스캔한 것. 그런 쪽에서는 Ctrl+F로 글자 하나 찾지 못합니다. 기초 콘크리트 강도가 어디에 적혀 있는지, 기둥 C1의 단면이 얼마인지, 피복 두께 주기가 어느 도면에 있는지 알려면 한 장씩 넘깁니다.
이 글의 질문은 이것입니다. 스캔 쪽이 모두 글자로 인식되어 보통 쪽처럼 검색된다면, 기술자는 매달 몇 시간을 돌려받는가? 그리고 그보다 먼저 오는 질문이 있습니다. 그 문자 인식이 한 세트를 끝까지 처리할 수 있는가.
1. 무엇이 바뀌나
도면 세트를 올리면 기계는 두 종류의 쪽을 나누어 따로 셉니다. 글자가 있는 쪽(파일에서 바로 읽음)과 스캔 이미지 쪽(인식이 필요함)입니다. 상태 표시는 파일 전체를 말합니다. 예를 들어 「312쪽: 글자 있음 267쪽, 스캔 45쪽 — 45쪽을 58초에 문자 인식」. 전에는 「45쪽 인식」이라고만 나와서, 읽는 사람은 기계가 45쪽에서 멈췄다고 받아들였습니다.
그다음:
- 스캔 쪽은 모두 문자 인식됩니다. 베트남어와 영어, 서버의 CPU에서 돌아갑니다. 스캔 쪽에서 나온 검색 결과에는 「OCR」과 신뢰도가 붙어서, 믿기 전에 도면을 다시 봐야 한다는 것을 알려 줍니다.
- 스캔 표제란에서 읽은 도면 번호와 제목은 글자 쪽과 마찬가지로 도면 목록에 들어갑니다.
- 중간에 끊겨도 처음부터 다시 하지 않습니다. 결과는 10쪽마다 저장되므로 다시 돌리면 빠진 쪽만 읽습니다. 시험: 171쪽 세트에서 30쪽째에 멈췄더니, 다시 돌릴 때 남은 141쪽만 읽었습니다.
- 큰 세트는 8 MB씩 나누어 올립니다. 서버 앞의 전송 네트워크는 100 MB를 넘는 요청을 거부하는데 브라우저는 아무것도 보여 주지 않습니다. 117 MB 세트가 5 KB/초로 18분 동안 기어간 적이 있습니다. 이제는 네트워크 오류가 난 조각만 다시 보내고, 다시 보내도 중복 파일이 생기지 않습니다.
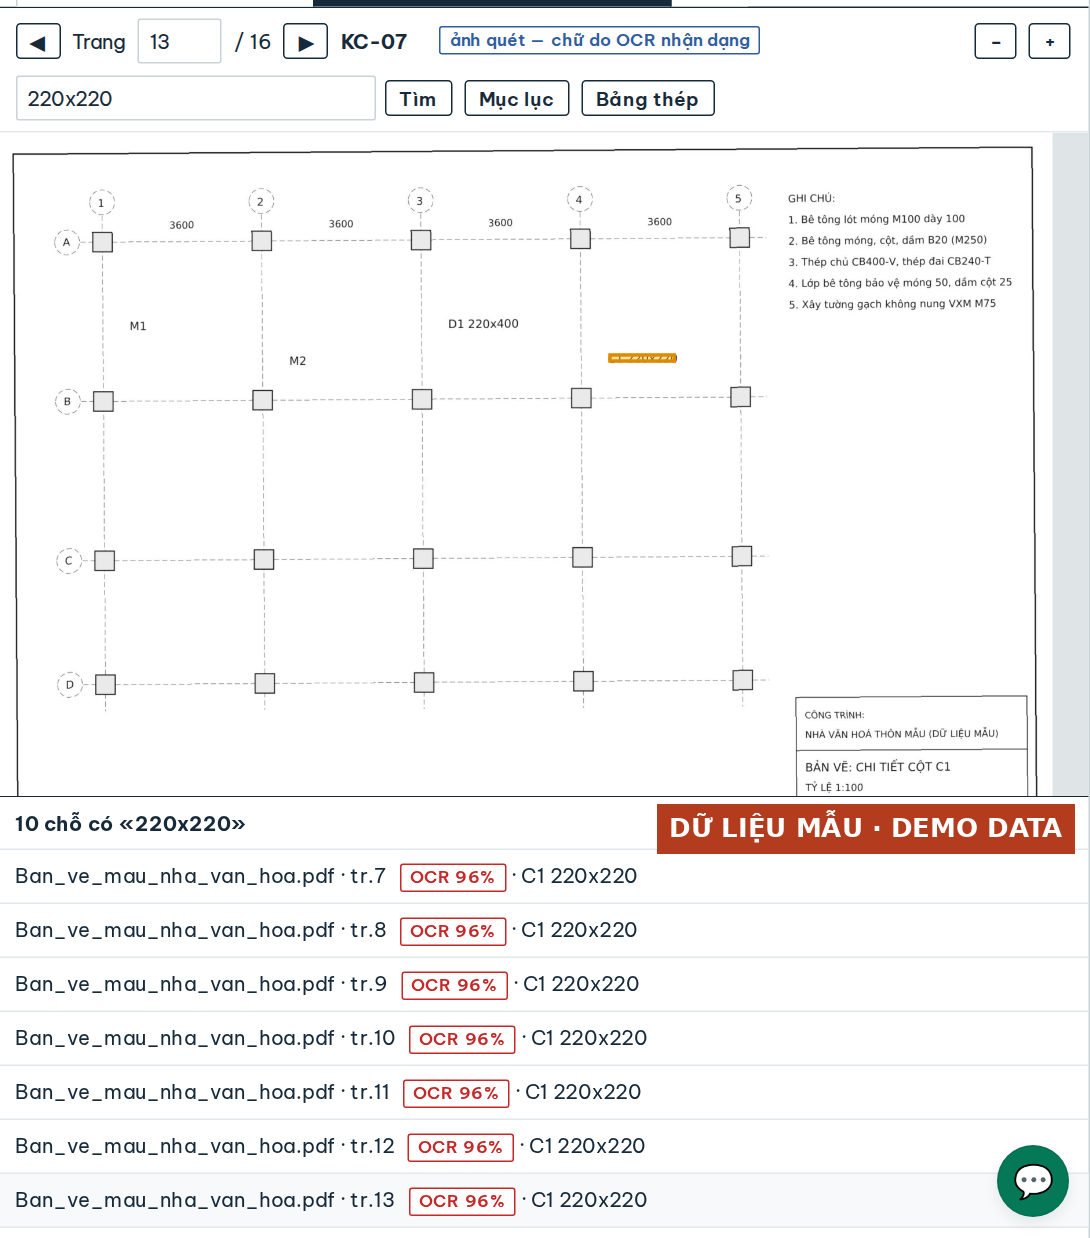
2. 먼저 오는 질문: 끝까지 도는가
스캔한 A3 한 장의 문자 인식은 혼자 돌면 1초에서 53초가 걸립니다. 171쪽 세트를 개발 기계에서 6개 프로세스 병렬로 돌리면 338초, 쪽당 약 2초였습니다.
실제 서버 — 4코어, 다른 시스템과 함께 쓰는 — 에서는 같은 세트가 처음에 끝나지 않았습니다. 300초 한도에서 멈췄습니다. 측정한 원인: 6개 프로세스가 동시에 돌고, 각 프로세스가 코어마다 스레드를 하나씩 열어 24개 스레드가 4개 코어를 다퉜습니다. 프로세스마다 스레드 하나로 묶고 병렬 수를 코어 수 빼기 1로 두자, 같은 기계에서 같은 171쪽이 352초에 끝났습니다.
이 점이 아래의 어떤 숫자보다 중요합니다. 인식이 끝나지 않는 세트는 「검색이 느린」 것이 아니라 아무것도 찾을 수 없는 것이고, 그 세트에서 무언가를 찾아야 하는 일은 모두 멈추거나 손으로 넘기는 방식으로 돌아갑니다. 아래 계산기는 처리가 끝난 세트의 시간만 셉니다. 완전히 멈추는 일은 들어 있지 않으므로 합계는 하한입니다.
3. 첫 번째 원천: 스캔 쪽에서의 검색
글자가 있는 쪽의 단어는 지금도 검색창으로 찾습니다. 스캔 쪽에 있으면 넘길 수밖에 없고, 평균적으로 절반쯤에서 만납니다. 스캔에 글자가 생기면 바르게 읽힌 부분은 검색 단계로 옮겨 가고, 잘못 읽힌 부분은 예전처럼 넘겨야 합니다. 위 그래프가 바로 이 계산입니다. 두 곡선 사이의 음영이 검색 한 번에 줄어드는 분입니다.
재는 법. 일주일 동안, 도면 세트에서 무언가를 찾을 때마다 표시하고 시간을 잽니다. 글자 쪽에서 찾은 경우와 스캔에서 찾은 경우를 나누어 셉니다. 바르게 읽는 비율은 자기 세트로 잽니다. 위치를 아는 단어 20개를 하나씩 검색해 올바른 쪽에 걸린 수를 셉니다.
믿을 만한 정도: 보통. 검색 횟수와 쪽당 초는 세트에 익숙한 사람과 처음 여는 사람 사이에 크게 다릅니다. 바르게 읽는 비율은 스캔 품질에 달려 있습니다. 기울거나 흐리거나 붉은 도장이 글자를 덮으면 뚜렷하게 떨어집니다.
4. 두 번째 원천: 도면 목록
재는 법. 다음에 도면 목록을 만들 때 스캔 20장으로 시간을 잽니다. 그리고 도구에서 고치지 않아도 번호가 맞게 나온 장 수를 셉니다.
믿을 만한 정도: 보통. 표제란은 설계 사무소마다 다르고, 낯선 형식은 바르게 읽히는 비율이 낮습니다.
5. 빼야 할 항목: 대기와 확인
171쪽 세트의 인식은 서버에서 약 6분, 뒤에서 돌고 AI 모델 사용료가 들지 않습니다 — 이 부분은 CPU에서 도는 문자 인식 소프트웨어를 씁니다. 그래도 사용자의 시간은 듭니다. 기다리고, 오류 표시 쪽을 다시 보고, 다시 실행을 누릅니다. 세트당 10분으로 치면: 4 × 10 ÷ 60 ≈ 한 달 0.7시간.
6. 합계
| 원천 | 시간/월 | 금액/월 (시간당 80,000동) |
|---|---|---|
| 스캔 쪽에서의 검색 | 8.9 | 71만 동 |
| 도면 목록 | 2.2 | 18만 동 |
| 대기와 확인 | −0.7 | −5만 동 |
| 돌려받는 시간 | 10.4 | 83만 동 |
한 달 4세트를 읽는 기술자 한 명에게 한 달 약 10시간, 예시의 급여로 1년에 1,000만 동 가까이 됩니다. 지금 그 세트들에서 검색과 목록 작성에 약 16.5시간이 듭니다.
한 번만 셉니다. 이 10시간은 돈이거나 더 많은 세트를 맡을 여력이지, 둘 다는 아닙니다. 그리고 2절에서 말했듯, 이 숫자는 오늘 아무도 아무것도 찾지 못하는 세트를 빼고 센 것입니다.
7. 이 ROI가 기대는 가정
찾는 단어가 바르게 읽히는 비율. 두 원천 모두의 밑에 있는 가정입니다. 계산기에서 0으로 두면 검색과 목록이 0이 되고 빼는 항목만 남습니다. 화면의 샘플 세트에서는 또렷한 인쇄 글자가 신뢰도 96%로 읽혔습니다. 실제 스캔에서는 손글씨, 도장 밑의 글자, Ø 같은 철근 표기가 자주 잘못 읽힙니다. 그래서 스캔 쪽에서 나온 결과에는 언제나 「OCR」과 신뢰도가 붙습니다. 도면을 다시 보라는 신호이지 장식이 아닙니다.
찾지 못했다고 없는 것은 아닙니다. 기계가 잘못 읽은 단어는 결과에 나오지 않습니다. 놓치면 돈이 드는 것 — 자재 주기, 평면도와 어긋나는 상세 — 에 대해서는 기술자가 여전히 세트를 알아야 합니다. 도구는 그 쪽까지 가는 길을 줄일 뿐 읽는 일을 대신하지 않습니다.
세트당 검색 횟수는 가장 부풀리기 쉬운 숫자입니다. 60을 믿기 전에 일주일을 재 보세요.
8. 자기 회사에서 재기
- 기준을 잡습니다. 작업 중인 세트를 고릅니다. 전체 쪽 중 스캔 쪽을 세고, 일주일 동안 검색 횟수와 한 번의 분을 기록하고, 스캔 20장으로 목록 작성 시간을 잽니다.
- 같은 세트를 도구로 돌립니다. 인식 시간, 실패한 쪽, 위치를 아는 단어 20개에서 바르게 읽는 비율을 적습니다.
- 같은 종류끼리 비교합니다. 철근 표기가 많은 구조 도면과 글자가 많은 건축 도면은 다릅니다. 구조는 구조와 비교합니다.
9. 기억할 것
검색할 수 없는 쪽은 필요할 때마다 눈으로 다시 읽어야 하는 쪽입니다. 문자 인식이 도면을 더 빨리 읽게 해 주지는 않습니다. 올바른 쪽까지 가는 수고를 없애 줍니다. 그리고 절약을 세기 전에 더 투박한 질문을 하세요. 가장 큰 세트가 정말 끝까지 도나요?
검색할 수 없는 도면 세트는 느린 것이 아니라 멈춘 것이다.
인식 시간(개발 기계에서 171쪽 338초, 4코어 서버에서 352초), 수정 전 300초 한도에서의 멈춤, 글자 쪽 267·스캔 45의 312쪽 세트, 5 KB/초로 올라가던 117 MB 세트는 Xây dựng G20에서 실제 설계 도서로 잰 것이며 익명 처리했습니다. 화면은 샘플 프로젝트의 것입니다. 한 달 세트 수, 스캔 비율, 검색 횟수, 쪽당 초, 바르게 읽는 비율, 급여는 예시 숫자입니다. 자신의 숫자로 바꾸세요.
이어서 읽기
-
청구서를 두 번 만들지 않기: 만들기 전에 회계 장부에 묻는다, 209건 중 199건은 이미 있었다
청구서 발행을 회계 프로그램에서 ERP로 옮길 때, 양쪽이 모두 청구서를 만드는 기간이 생깁니다. ERP가 만들기 전에 회계 장부에 직접 묻는다면 한 번의 전환에서 중복 몇 건을 피할 수 있을까 — 정리하지 않아도 되는 중복 한 건은 얼마의 가치일까?
-
내역서를 링크 하나로 공유하기: 엑셀을 메일로 돌리는 데 몇 시간이 들고, 「어느 게 최신판?」은 왜 생기나
내역서 한 벌은 메일로 보낸 엑셀 파일로 2–4명 사이를 돌고, 늘 누군가 「어느 게 최신판?」이라고 묻습니다. 한 벌 전체 — 도면, 물량표, 숫자 하나하나의 근거 — 가 하나의 공유 프로젝트 뒤에 있고, 이메일로 함께 작업에 초대하거나 계정이 필요 없는 보기 전용 링크를 보낼 수 있다면, 검토 왕복은 매달 몇 시간을 돌려받는가?
-
원래 발주서 단가로 청구하기: 납품서는 21,000, 체인의 PO는 30,000
유통 체인은 공급자의 납품서가 아니라 자기 PO에 적은 단가로 지급합니다. 기계가 PO 단가를 읽어 차이가 타당하면 그 단가로 청구하고, 다음을 위해 가격표를 고친다면 매달 얼마의 가치가 있을까 — 그리고 어느 행은 여전히 사람이 정해야 할까?